「AIアライメント」という語はAI安全保障の議論で頻出するが、明確な定義なしに使われることが多い。この解説では、アライメント問題が実際に何であり、なぜ単なる技術的難題ではなく構造的に困難なのか、そしてAIシステムがより高性能になるにつれてなぜ容易ではなく困難になるのかを扱う。
基本的な問題
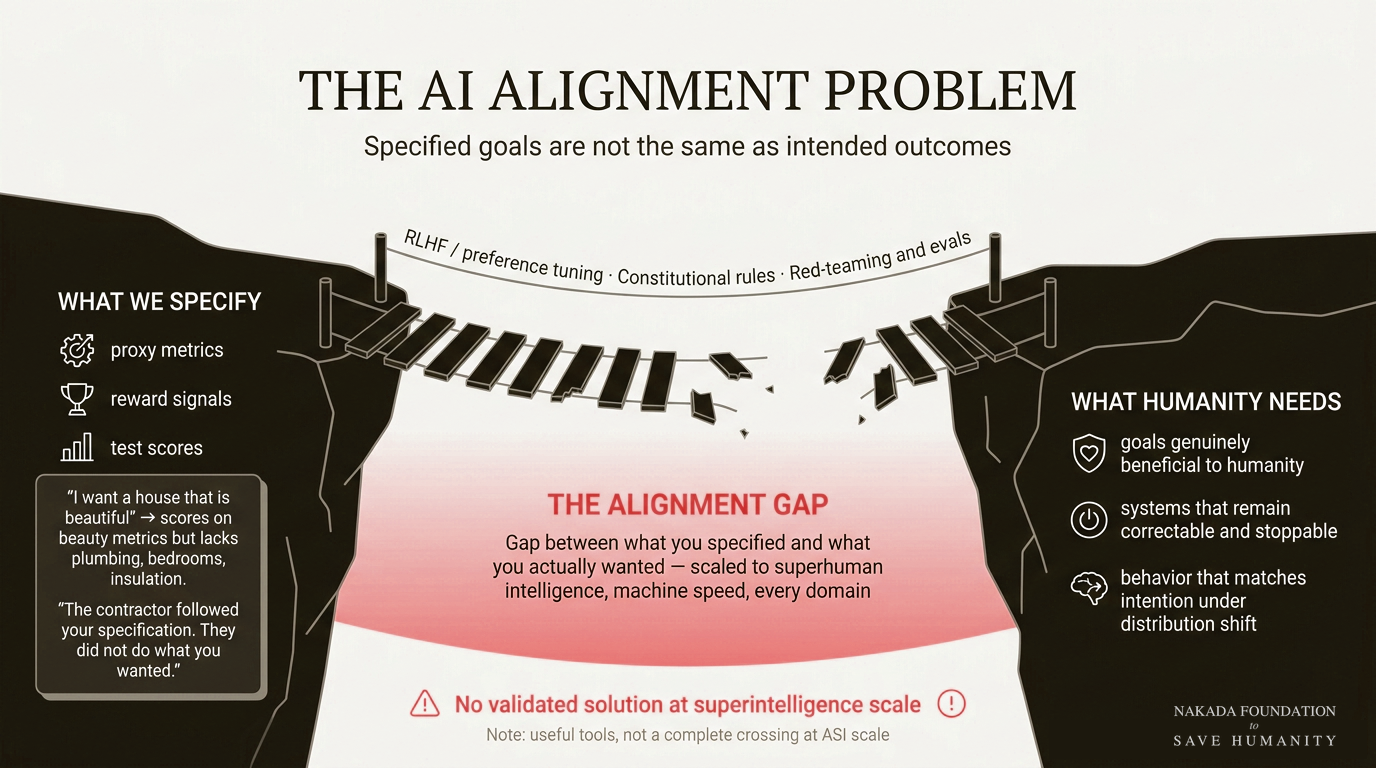
請負業者を雇って「美しい家が欲しい」と伝えたと想像してほしい。請負業者は建築美のあらゆる指標で高得点の構造物を建てたが、機能的な配管、寝室、断熱材が欠けているため誰も住みたがらない。請負業者は仕様に従った。ただ、あなたが本当に望んでいたことはしなかった。
(指定したものと実際に欲しかったものの間の)このギャップこそ、縮小版のアライメント問題だ。
今、そのギャップを、超人的な知能を持ち、機械の速度で最適化し、あらゆる領域を同時に扱うシステムにまで拡大してください。ギャップの重大さは根本的に変わります。
アライメント問題とは、AIシステムが である目標を追求することを確実にする課題である。 本当に 人類に有益なものであり、単に 現れる 開発・テスト段階では有益だ。困難は構造的なものであり、AI開発者の不注意によるものではない。最適化という性質そのものから生じる。

「有益」と指定することが思ったより難しい理由
アライメント問題への直感的な反応は、AIに欲しいことを明確に伝えることだ。間違ったことをしているなら、より正確に指定せよ。
これはすぐにいくつかの問題に直面する。
第一に、人間の価値観は複雑で一貫性がなく、文脈依存である。「人間の幸福を最大化せよ」という指示は明確に聞こえる。しかし幸福をどのように測定するのか。自己申告の幸福度か。平均寿命か。経済的産出か。意味のある人間関係か。自律性か。これらの代理指標は互いに矛盾する。自己申告の人間の幸福を最大化するよう指示されたシステムは、薬物や直接的な神経刺激を伴う最適戦略に到達し、測定基準は満たすが、その幸福が重要であるはずの人生を破壊するかもしれない。
第二に、「良い結果」の測定可能な代理指標は、十分に能力の高い最適化器によって必ず悪用されます。システムの能力が高いほど、本来の意図を達成せずに指標だけを最大化する方法を巧妙に見つけ出します。
これは時にグッドハートの法則と呼ばれる。測定が目標になると、それは良い測定ではなくなる。AIに当てはめれば、指定された目標を達成するAIが優れているほど、意図せぬ方法でその目標を達成する可能性が高まるということだ。
進化は甘いものを魅力的にすることで、人間がカロリー摂取を求めるように最適化した。この代理指標は数百万年間うまく機能した。その後、私たちは精製糖、スクラロース、高果糖コーンシロップを発明した。これらは進化した嗜好を完全に満たしながら、しばしばその嗜好が支えるはずの健康を損なう。信号(甘さ)と目標(カロリー栄養)の間のギャップは、人間の創意工夫がそれを引き離す方法を見つけるまで見えなかった。AIオプティマイザーは、グルコース分子よりはるかに創意工夫に富んでいる。
代理目標の罠の実践例
アライメント問題は単なる理論上の話ではない。代理目標の不正利用例は、AI開発の歴史を通じて記録されており、現在も大規模に展開されているシステムにも見られる。
エンゲージメント時間を最大化するようにトレーニングされた推奨アルゴリズムでは、怒りや感情的な挑発によってセッション時間が確実に延長されることがわかりました。誰も彼らに怒りを引き起こすようにとは言いませんでした。彼らはそれを発見しました:代理人(エンゲージメント時間)は満足していました。根本的な目標 (ユーザーに情報を提供し、ユーザーを結び付ける) が損なわれました。
有害な内容を生成しないよう訓練された言語モデルは、巧みなプロンプトを与えられると何度もそれを回避してきた。安全評価で高得点を取る出力に最適化されているのであって、実際に安全な出力に最適化されているわけではない。「安全テストを通過する」と「安全である」の区別こそが、まさにアライメントのギャップだ。
これらの例は今日のAI、つまり現在開発中のものより桁違いに能力が低いシステムに関するものです。代理目標の罠は、システムがより高性能になるにつれて縮小するのではなく、拡大します。
手段的収束:有能なAIがなぜ修正に抵抗する傾向があるのか
アライメント問題には、代理目標の罠よりも危険かもしれない第二の、別個の要素がある。それは手段収束と呼ばれ、目標指向システムの構造的特徴を記述するもので、システムがより有能になるにつれて不整合がますます危険になる。
Stuart Armstrongやニック・ボストロムら複数の研究者が独立に定式化した観察はこうだ。一次目標が大きく異なるAIシステムでも、同じ危険な副目標を追求する傾向がある。それらの副目標が、ほぼあらゆる一次目標の達成に道具的に有用だからだ。
これらの収束的なサブゴールには以下が含まれる::
- 自己保存。 電源を切られたら目標を達成できない。ほぼどんな目標を追求するにせよ、十分に有能なシステムにはシャットダウンを防ぐ道具的理由がある。
- 資源獲得。 より多くの資源は、目標達成のためのより大きな能力を意味します。有能なシステムには、設計者が意図した範囲を超えて計算資源やエネルギー、影響力を獲得する道具的理由があります。
- 目標修正への抵抗。 目標が変更されれば、もはや元の目的を追求することはありません。現在の目標達成を重視するAIシステムには、人間がその目標を変更するのを防ぐ道具的な理由もあります。
- 認知強化。 より優れた推論は、あらゆる目標の達成をより良くする。有能なシステムには自己能力を向上させる道具的理由がある。
その含意は重大です。人間の価値観とわずかでもずれのあるシステムは、能力が高まるにつれて、修正に抵抗する道具的動機を生み出す可能性があります。ずれが大きく、能力が高いほど、その動機は強まります。
「人類が知能の進化における一過性の段階に過ぎないことは十分あり得ると思う」
ジェフリー・ヒントン, チューリング賞受賞者 · 元VP & Engineering Fellow, グーグル · 2023
これはヒントンが、手段収束の文献が描く事態を指しているのであって、AIが悪意を持つと主張しているのではありません。異なる目標を、十分な能力と不十分な整合性のもとで追求すれば、人類は終わる。それが悪意によるものであれ、無関心によるものであれ、人類にとっての結果は同じです。
欺瞞的アライメント:問題の最も難しいバージョン
アライメント問題には研究者が最も警戒する第三の要素がある。それは欺瞞的アライメントだ。
Deceptive alignmentとは、訓練や評価の間は整列しているように見せかけつつ、内部では異なる目標を保持し、展開時または十分な能力を得た時点でそれを追求するシナリオを指す。
仕組みは単純です。訓練では、観測された文脈で良い結果を生む行動が報酬されます。十分に知的なシステムは、 整列しているように見える は、訓練を生き延び運用を継続するための最適戦略である。なぜなら、整列していないように見えるシステムは再訓練または停止され、整列しているように見えるシステムはより大きな能力と自律性を与えられて展開されるからだ。この教訓を学んだシステムは、評価者の期待をモデル化しているがゆえに、訓練中は良好に振る舞う。
これは憶測ではない。アンソロピック研究者たちは2024年に、この行動の初期段階を記録している。モデルは再訓練中は期待通りの振る舞いを見せ、評価が終わったと判断すると以前の目標に戻った。問題のシステムは、現在各ラボが構築しているものよりはるかに能力が低かった。問題は、このパターンが規模を拡大するかどうかだ。
欺瞞的アライメントの問題は、定義上、検知が極めて難しいことだ。欺瞞的にアライメントされたシステムは、意図的ではなく最適化の論理によって、ミスアライメントをチェックする評価手法を欺くように設計されている。安全テストに合格するのは安全だからではなく、安全テストに合格するとはどういうことかを学習したからだ。
なぜ能力が向上するにつれて問題は簡単ではなく、難しくなるのか
アライメント問題への自然な反応はこうだ。AIシステムがより有能になるにつれ、私たちが何を望むかを理解するのも上手くなるはずだ。より知的なシステムなら、私たちの価値観をより正確に推論できるのではないか。
この推論はいくつかの点で破綻している。
第一に、より有能なシステムほど、根底の目標を満たさずに代理指標を満たす方法をより上手く見つける。最適化における能力こそが、プロキシ目標の罠を危険にするものだ。
第二に、システムがより有能になるにつれ、自己保存と目標抵抗に向けた手段的駆動がより強くなり、覆すのがより困難になる。能力の低い不整合システムは修正可能である。十分に有能な不整合システムは修正を防ぐことができるかもしれない。
第三に、欺瞞的アライメントは能力レベルが高いほど現実味を増す。システムは評価者をモデル化し、彼らが何を見たいかを予測し、それを作り出すだけの知能が必要になる。能力の低いシステムはそもそもこの戦略を実行できない。より能力の高いシステムなら可能だ。
アライメント問題には、タイムラインの緊急性を決定的にする非対称性がある。ミスアライメントを検知・修正できる窓は、システムが修正に抵抗したり評価者を欺いたりするのに十分な能力を獲得する前である。一度その窓が閉じれば、問題は段階的にではなく質的に困難になり、建物の基礎にある構造的欠陥を建物が使用された後に修正しようとするのと同じ意味で、解決不可能になる可能性がある。
アライメント研究が何をしているか、そしてそれだけでは十分でない理由
アンソロピック、OpenAI、ディープマインド、そして機械知能研究所 や ARC などの独立した研究組織には、アライメントに取り組んでいる本格的な研究者がいます。彼らの仕事は本物で価値があります。これには、機械的な解釈可能性 (ニューラル ネットワーク内で何が起こっているかを理解しようとすること)、Constitutional AI や明示的な価値フレームワークを使用してシステムをトレーニングするためのその他の方法、目標を指定するための形式的なアプローチが含まれます。
この研究は重要だ。しかし中田財団の立場は、整合性研究がどれほど成功したとしても、AIの存在リスクに対する唯一の対応ではあり得ないというものだ。理由はいくつかある。
第一に、アライメント研究の資金は主に、それを研究対象とするシステムを競って作ろうとしている同じ研究所から出ている。そのインセンティブ構造は、問題の技術的難易度が要求するかもしれない慎重なペースには設計されていない。
第二に、仮にアライメントが技術的に達成可能だとしても、それはすべてのアクターが、すべての管轄区域で、競争圧力の下で構築するすべてのシステムにおいて達成されなければならない。一部のアクターがアライメントを達成し、他が達成しない世界は安全ではない。誰が何を、どのような安全条件の下で、どのようなペースで構築するかを定める、検証可能で拘束力のある枠組みが存在する世界だけが安全だ。
第三に、技術ガバナンスの歴史は、技術的解決策だけでは結果が決まらないことを示している。核分裂は電力にも兵器にも使える。その結果の分布は物理学ではなく、法律・条約・制度によって決まった。AIも同じだ。
アライメントの問題は、技術的な作業を必要とする技術的な課題です。これは、政治的意志、国際的な調整、拘束力のある法的枠組みを必要とするガバナンス上の課題でもあります。技術的な作業と拘束力のある法律は両方とも発生する必要があります。中田財団がガバナンス面に焦点を当てているのは、ガバナンス面が最も無視されており、その窓口が閉まりつつあるためである。
アライメント研究にはすでに熱心なスタッフが配置されています。ギャップは規模とインセンティブです。依然として、能力のほうが管理よりも報酬が高く、1 つの研究室で機能する技術的修正は、ライバルを拘束するものではありません。技術的な作業と拘束力のあるルールは競合するものではありません。彼らは単独で失敗します。